Uma aplicação pode estar a funcionar corretamente e, ainda assim, sofrer uma interrupção porque o servidor físico onde está alojada necessita de manutenção. No Microsoft Azure, tal como em qualquer plataforma de computação, os componentes de hardware e software precisam de ser atualizados, reparados e, eventualmente, substituídos.
A diferença está na forma como a plataforma reduz o impacto dessas operações e nos mecanismos que disponibiliza para que as aplicações se preparem. Neste contexto, compreender os eventos de manutenção, maintenance events, e o serviço Scheduled Events é essencial para conceber soluções de alta disponibilidade e resiliência.
Ao longo deste artigo, o foco estará nas Azure Virtual Machines e nos Virtual Machine Scale Sets, onde estes mecanismos permitem coordenar a manutenção da infraestrutura com o comportamento das aplicações.
1- Manutenção e Disponibilidade: Duas Responsabilidades Complementares
O Azure gere a infraestrutura física que suporta as máquinas virtuais: servidores, componentes de rede, hipervisores e outros elementos da plataforma. A Microsoft procura realizar a manutenção com o menor impacto possível, recorrendo, por exemplo, a atualizações que preservam a memória ou à migração em direto de máquinas virtuais.
Contudo, reduzir o impacto na infraestrutura não equivale a garantir que a aplicação nunca é interrompida.
Uma pausa de poucos segundos pode ser praticamente impercetível para uma aplicação web com várias instâncias. A mesma pausa pode afetar uma aplicação de processamento em tempo real, uma ligação persistente ou uma operação sensível à latência.
Por isso, a disponibilidade resulta da combinação de duas capacidades:
- A plataforma minimiza e comunica as interrupções, sempre que possível.
- A aplicação tolera falhas e reage aos avisos, através de redundância, distribuição de tráfego e automatização.
A ideia central é simples: uma arquitetura resiliente não pressupõe que a manutenção deixa de existir; prepara-se para continuar a funcionar quando ela acontece.
2- Que Situações podem afetar uma Máquina Virtual ?
A documentação da Microsoft distingue três cenários: manutenção planeada, manutenção não planeada de hardware e indisponibilidade inesperada. Embora possam produzir efeitos semelhantes, têm origens e possibilidades de antecipação diferentes.
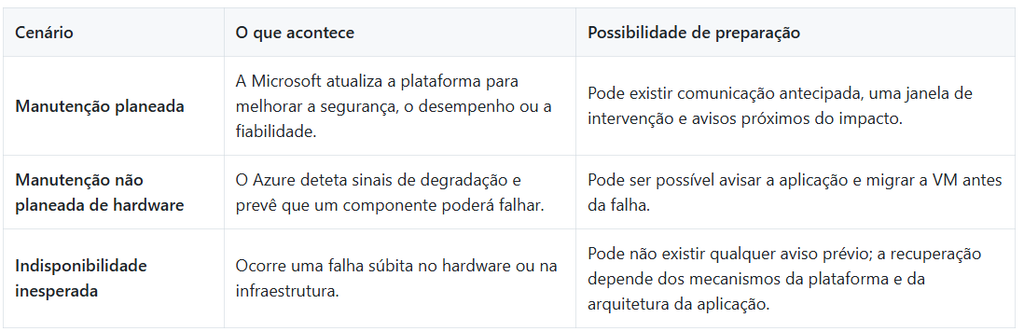
Manutenção planeada
A maioria das atualizações da plataforma é realizada sem afetar as máquinas virtuais. Quando não é possível evitar completamente o impacto, o Azure procura utilizar o mecanismo menos disruptivo.
Algumas operações exigem apenas uma breve pausa. Outras podem obrigar ao reinício da VM.
Nos cenários elegíveis que exigem reinício, o Azure disponibiliza uma janela de manutenção self-service, durante a qual o cliente pode iniciar a operação num momento mais conveniente. A duração depende do tipo de intervenção: a documentação indica, tipicamente, cerca de 35 dias para manutenção do anfitrião e 14 dias para desativação de hardware, podendo existir exceções, nomeadamente em intervenções urgentes.
Depois da janela self-service, o Azure executa a operação durante a janela de manutenção programada. Estes períodos não devem, por isso, ser interpretados como um direito universal de adiar qualquer manutenção.
Manutenção não planeada de hardware
Nem todas as falhas acontecem sem sinais prévios. Quando o Azure identifica hardware degradado, mas ainda operacional, pode tentar mover as máquinas virtuais para um servidor saudável através de live migration, ou migração em direto.
Esta operação preserva a memória e procura evitar um reinício, embora possa provocar uma breve pausa ou degradação temporária do desempenho. A sua execução depende das condições do anfitrião e da compatibilidade da VM: a migração em direto é um mecanismo de mitigação, não uma garantia de sucesso em qualquer circunstância.
Indisponibilidade inesperada
Se um componente falhar subitamente, pode já não ser possível migrar a VM preservando a sua execução. O Azure tenta recuperar os recursos e, quando necessário, restabelecer a máquina virtual num anfitrião saudável. Este processo pode implicar um reinício e perda de dados existentes no armazenamento temporário.
Daqui resulta uma regra importante: os dados necessários à recuperação da aplicação não devem depender exclusivamente da memória ou do disco temporário de uma VM.
3- Maintenance events e Scheduled Events não são a mesma Coisa
Apesar da proximidade dos termos, existe uma diferença fundamental:
Um maintenance event é a ocorrência de uma operação de manutenção. Scheduled Events é o mecanismo que permite à aplicação obter informação sobre operações com impacto na VM e preparar uma resposta.
Além disso, o âmbito de Scheduled Events não se limita à manutenção planeada da Microsoft. Pode incluir:
- Operações iniciadas pela plataforma, como reinícios e migrações.
- Intervenções motivadas por hardware degradado.
- Informação associada à recuperação após uma falha de hardware.
- Operações iniciadas por um utilizador, como reiniciar ou voltar a implementar uma VM.
- Remoção de máquinas virtuais Spot.
Assim, “Scheduled” não significa que haverá sempre um aviso com antecedência suficiente. Perante uma falha súbita, o evento pode ser disponibilizado já no estado Started, sem uma fase prévia de preparação.
4. Como funciona o Scheduled Events ?
A forma tradicional de consumir Scheduled Events utiliza o Azure Instance Metadata Service, IMDS.
A aplicação, ou um agente a executar na VM, consulta periodicamente um endpoint REST local:
Http
GET http://169.254.169.254/metadata/scheduledevents?api-version=2020-07-01
Metadata: true
O endereço 169.254.169.254 é acessível a partir da própria máquina virtual e não corresponde a um endpoint público. O cabeçalho Metadata: true é obrigatório.
Quando não existem eventos, a resposta contém uma lista Events vazia. Quando existem operações relevantes, essa lista inclui informação como a seguinte.
Exemplo ilustrativo:
JSON
{
  "DocumentIncarnation": 12,
  "Events": [
    {
      "EventId": "11111111-2222-3333-4444-555555555555",
      "EventType": "Reboot",
      "ResourceType": "VirtualMachine",
      "Resources": ["vm-app-01"],
      "EventStatus": "Scheduled",
      "NotBefore": "Tue, 17 Nov 2026 02:00:00 GMT",
      "Description": "Host server is undergoing maintenance.",
      "EventSource": "Platform",
      "DurationInSeconds": -1
    }
  ]
}
Neste exemplo, a aplicação deve perceber que a VM vm-app-01 poderá ser reiniciada e iniciar os seus procedimentos de preparação.
Os campos mais importantes são:
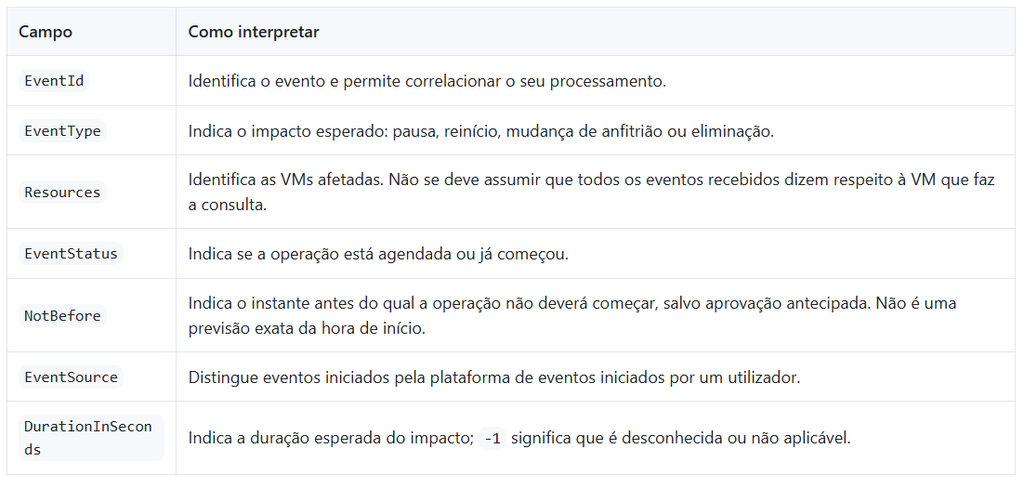
A verificação de Resources é especialmente importante porque, em determinados agrupamentos, uma VM pode receber eventos relativos a outras máquinas do mesmo Availability Set ou grupo de colocação de um Scale Set.
5- Tipos de Eventos e Antecedência de Notificação
Os principais tipos de Scheduled Events são os seguintes. Os tempos apresentados correspondem aos períodos de aviso documentados para o fluxo normal de agendamento; não se aplicam como garantia perante falhas súbitas de hardware.
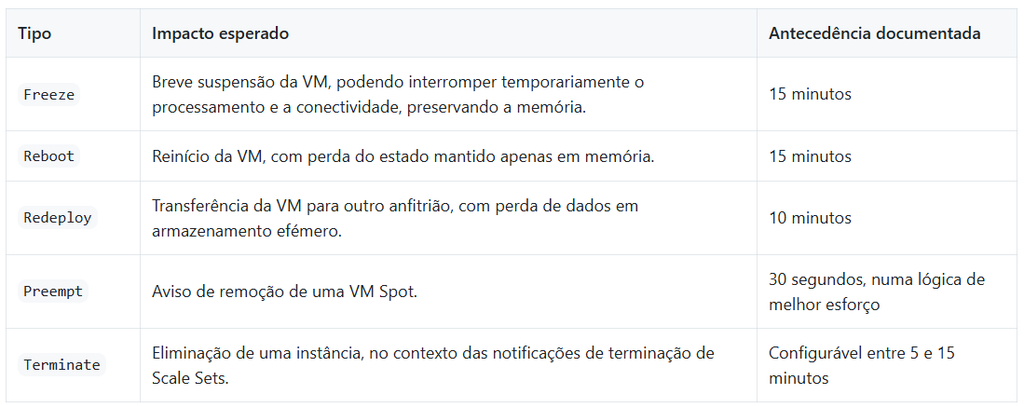
Estes valores representam tempo para preparar a aplicação, não a duração da indisponibilidade.
Por exemplo, um aviso de Freeze com 15 minutos de antecedência não significa que a VM ficará suspensa durante 15 minutos
6- O Ciclo Correto: Preparar, Aprovar e Recuperar
Uma integração eficaz não se limita a registar que foi recebido um evento. Deve coordenar o comportamento da aplicação durante todo o processo.
Preparar a Aplicação
Ao receber um evento no estado Scheduled, a aplicação pode deixar de aceitar novo trabalho, concluir pedidos em curso, guardar um ponto de recuperação ou transferir a função de réplica principal.
A resposta deve ser proporcional ao evento. Uma pausa breve pode exigir apenas tolerância a timeouts; uma terminação exige que o trabalho necessário seja transferido ou persistido.
Aprovar Apenas quando estiver Preparada
Depois de concluir a preparação, a aplicação pode aprovar o evento através de um pedido POST com o respetivo EventId. Aprovar significa informar o Azure de que pode avançar, eventualmente antes de NotBefore. Não significa cancelar a manutenção.
Da mesma forma, não aprovar o evento não permite bloqueá-lo indefinidamente: quando o prazo termina, a operação pode prosseguir.
Existe ainda um cuidado essencial: a aprovação abrange todos os recursos indicados em Resources, e não apenas a VM que enviou o pedido. Quando o evento envolve várias instâncias, a aprovação deve ser coordenada.
Aguardar o fim da Operação
O estado Started indica que a operação começou, mas não significa que o impacto já terminou. No endpoint IMDS não existe um estado Completed: o evento deixa de aparecer na lista quando termina ou é cancelado. A aplicação deve acompanhar esse evento específico e, antes de retomar o serviço, confirmar também a sua própria saúde.
Não é seguro repor uma carga sensível apenas porque já passou o tempo estimado de interrupção. Podem existir impactos adicionais enquanto o evento permanecer em Started.
7- Exemplo Prático: Uma aplicação web com várias Instâncias
Considere-se uma aplicação distribuída por três VMs, em várias Availability Zones, atrás de um Azure Load Balancer. As sessões e os dados necessários à continuidade do serviço são mantidos fora das instâncias web.
Uma das VMs recebe um evento Reboot.
O fluxo de resposta pode ser o seguinte:
- O agente identifica que a VM consta de
Resources. - A aplicação entra em modo de drenagem e sinaliza que não deve receber novos pedidos, de acordo com o desenho das sondas de estado.
- Os pedidos em curso terminam dentro de um prazo limitado.
- A aplicação persiste o estado necessário e aprova o evento.
- O Azure realiza a manutenção.
- Depois do arranque e da conclusão do evento, a aplicação valida as dependências e volta a aceitar tráfego.
Neste cenário, a manutenção continua a afetar uma VM, mas as restantes instâncias mantêm o serviço disponível.
Importa, contudo, distinguir deixar de encaminhar novas ligações de concluir ligações existentes. A drenagem deve ser suportada e coordenada pela aplicação; um balanceador de carga, por si só, não resolve todos os pedidos ou ligações já estabelecidos.
8- Scheduled Events não Substitui uma Arquitetura de Alta Disponibilidade
Uma única VM pode receber um aviso, preparar-se corretamente e, ainda assim, deixar o serviço indisponível durante um reinício. O aviso não cria uma segunda instância para servir os utilizadores.
A proteção deve combinar diferentes mecanismos:
Availability Sets. Distribuem VMs por domínios de falha, fault domains e de atualização, update domains. Os primeiros reduzem a exposição a falhas de infraestrutura partilhada; os segundos permitem escalonar reinícios de manutenção planeada. Num Availability Set, apenas um update domain é reiniciado de cada vez durante esse processo. Não oferecem, porém, o mesmo isolamento que várias zonas.
Availability Zones. Permitem distribuir instâncias por localizações fisicamente separadas dentro de uma região. A aplicação e os dados têm de estar preparados para continuar a funcionar com uma zona indisponível. Colocar uma única VM numa zona não cria, por si só, redundância entre zonas.
Virtual Machine Scale Sets. Facilitam a gestão de várias instâncias e da capacidade. A resiliência depende também da distribuição escolhida, das políticas de atualização e da capacidade que permanece disponível durante uma intervenção.
Resiliência aplicacional. Timeouts adequados, repetição controlada de operações transitórias, idempotência e persistência de estado continuam a ser necessários para lidar com falhas sem aviso.
Se o requisito incluir sobreviver à indisponibilidade de uma região inteira, é necessário acrescentar uma estratégia multirregional de continuidade e recuperação.
9- Que Ferramenta utilizar em casa Situação ?
Os mecanismos de manutenção e observabilidade têm funções complementares.
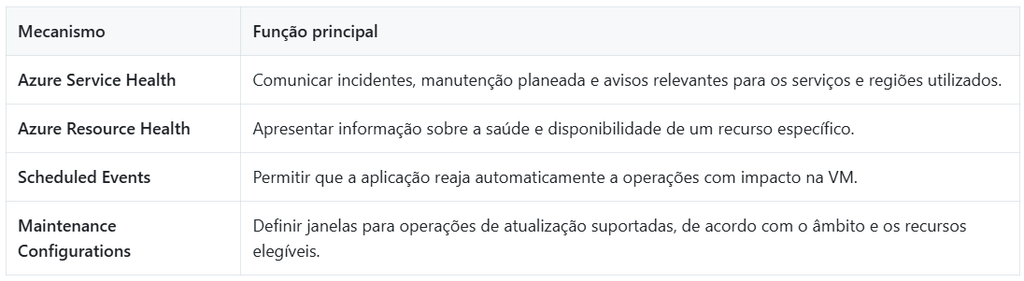
Uma forma simples de os distinguir é esta: Service Health informa as equipas; Scheduled Events permite preparar a aplicação; Resource Health ajuda a compreender o estado do recurso.
Maintenance Configurations acrescenta controlo de agendamento, mas não permite escolher livremente quando ocorre toda e qualquer intervenção. O âmbito Host, por exemplo, suporta determinados recursos isolados e Dedicated Hosts; o âmbito Guest integra-se com o Azure Update Manager para atualizações do sistema operativo convidado.
Por isso, agendar atualizações dentro da VM não é o mesmo que controlar a manutenção do anfitrião físico.
À data da documentação consultada, Scheduled Events através de IMDS encontra-se em disponibilidade geral. As integrações através de Event Grid e Azure Resource Graph estão em pré-visualização, distinção que deve ser considerada antes da sua adoção em produção.
10- Recomendações para uma Implementação Rrobusta
A Microsoft recomenda consultar o endpoint de Scheduled Events uma vez por segundo, para maximizar o tempo disponível para reação. A integração deve estar permanentemente operacional: a primeira chamada ativa o serviço e pode demorar até dois minutos, podendo a receção de eventos iniciar-se nos cinco minutos seguintes. Se não houver consultas durante 24 horas, o serviço é desativado até voltar a ser solicitado. Não se deve, portanto, esperar por uma manutenção para o ativar.
Além disso, uma implementação de produção deve:
- Tratar falhas de consulta como falhas, e não como prova de que não existem eventos.
- Processar eventos de forma idempotente, evitando repetir ações destrutivas ou transferências de função a cada consulta.
- Limitar o tempo de preparação, porque a manutenção não pode ser adiada indefinidamente.
- Manter capacidade e redundância suficientes durante a saída de uma instância.
- Testar em ambiente controlado, incluindo reinícios iniciados através do Azure e cenários de falha sem aviso.
Receber e registar o evento é apenas o primeiro passo. O verdadeiro critério de sucesso é saber se a aplicação continua a cumprir os seus objetivos de serviço quando uma instância deixa de estar disponível.
Para concluir, a manutenção faz parte do funcionamento normal de uma plataforma cloud. O objetivo não é eliminá-la, mas evitar que se transforme numa interrupção significativa para o negócio.
No Azure, os mecanismos de manutenção procuram reduzir o impacto sobre as máquinas virtuais. Scheduled Events permite que as aplicações participem nesse processo, preparando-se antes de uma pausa, reinício, migração ou terminação, quando existe aviso.
No entanto, Scheduled Events é um complemento da alta disponibilidade, não um substituto da redundância. A combinação de várias instâncias, isolamento entre domínios de falha, distribuição de tráfego, persistência de dados e recuperação automática é o que transforma uma notificação de manutenção numa operação controlada.
Uma solução verdadeiramente resiliente sabe preparar-se quando é avisada, e continuar a funcionar quando não é.
Para leitura adicional consulte os links da documentação:
- Maintenance and updates – Azure Virtual Machines | Microsoft Learn
- Understand VM reboots – Azure Virtual Machines | Microsoft Learn
- Scheduled Events for Azure Virtual Machines – Azure Virtual Machines | Microsoft Learn
- Availability sets overview – Azure Virtual Machines | Microsoft Learn
- Availability options for Azure Virtual Machines – Azure Virtual Machines | Microsoft Learn
- What is Azure Service Health? – Azure Service Health | Microsoft Learn
- Overview of Maintenance Configurations for Azure virtual machines – Azure Virtual Machines | Microsoft Learn